Oracle 19c 体系结构:从启动到 SQL 执行的一条完整主线
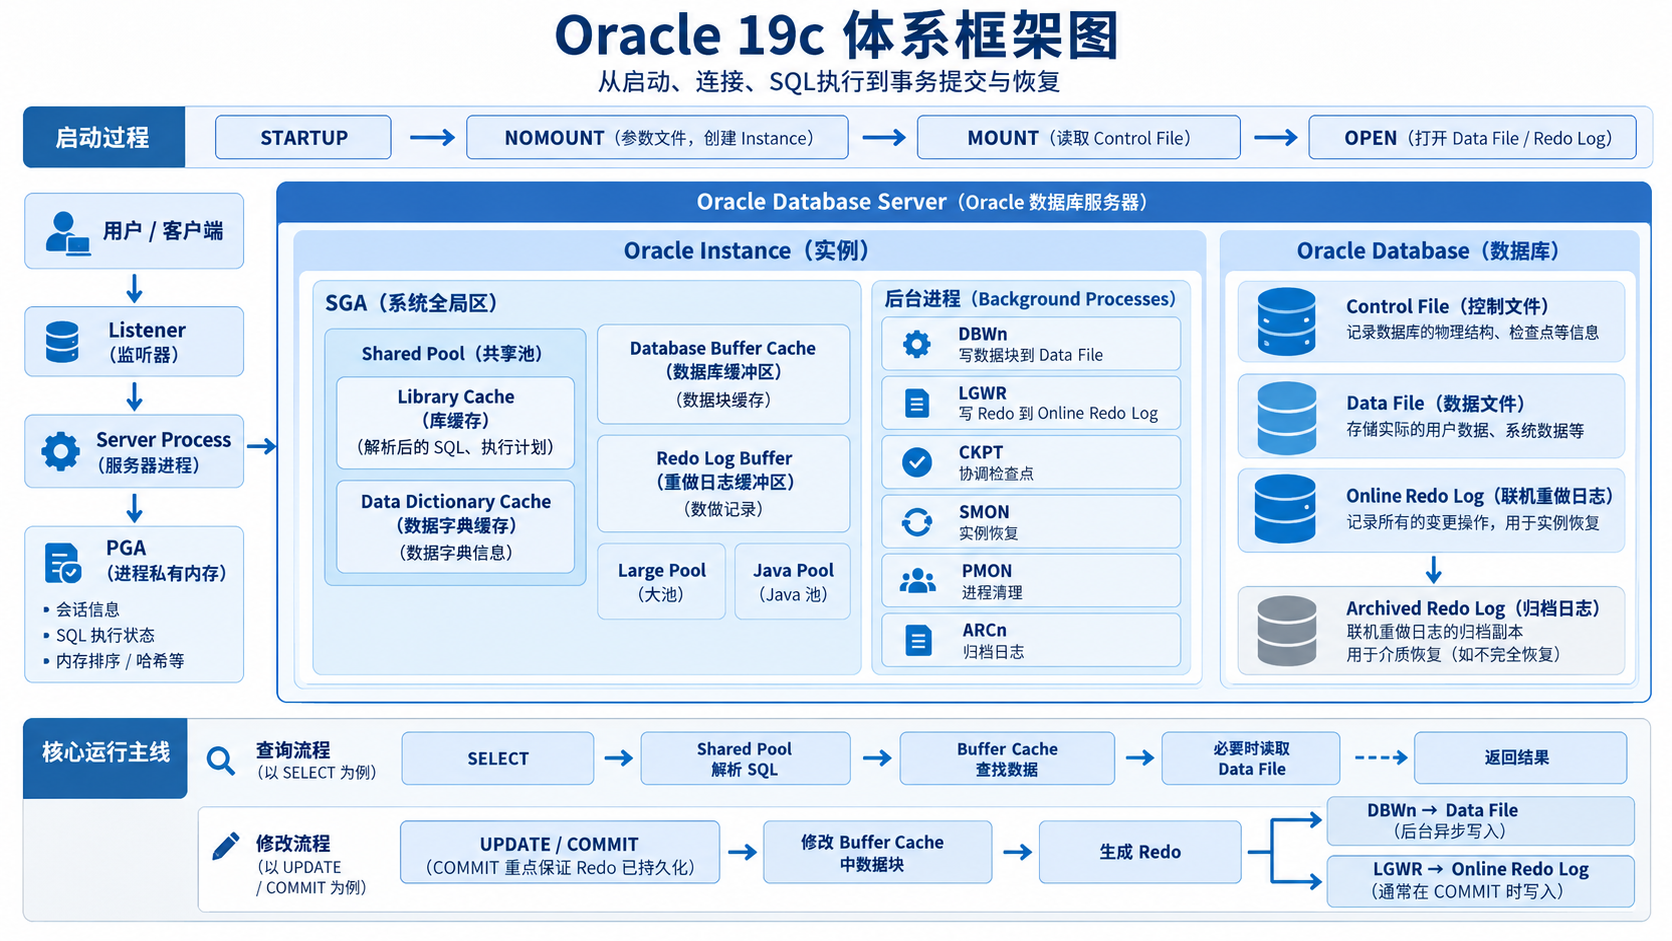
Oracle 先把磁盘上的数据调到内存里处理;SQL 在共享内存中解析,数据在 Buffer Cache 中读取和修改;修改同时产生 Redo,由 LGWR 优先把日志写入磁盘保证安全,再由 DBWn 将真正的数据块逐渐写入 Data File;CKPT 协调数据库状态推进,ARCn 保存历史日志,而当系统出现故障时,Oracle 又可以利用 Redo 把数据库恢复回来。
刚接触 Oracle 时,Instance、SGA、PGA、DBWn、LGWR、Redo、Control File 这些名词很容易让人觉得零散、难记。
其实 Oracle 19c 的体系结构可以沿着一条很清晰的主线理解:
数据库启动 → 用户连接 → SQL 解析 → 数据读取或修改 → 日志与数据写盘 → 故障恢复
只要把这条流程走通,大多数核心组件就能自然串起来,而不需要死记硬背。
一、先用“仓库”理解 Oracle
可以把 Oracle 想象成一个大型电商仓库。
真正的商品最终放在仓库货架上,这类似于 Oracle 中的 数据文件(Data File)。但如果员工每处理一个订单,都要跑到仓库最深处重新取货,效率会非常低。因此仓库前面通常会设置一个临时工作区,把近期经常使用的商品先放在那里,这就类似于 数据库缓冲区(Database Buffer Cache)。
员工处理订单时,还要知道商品在哪里、库存是多少、客户是否有权限、订单应该怎样处理更快,这些共享信息可以类比为 共享池(Shared Pool)。
仓库还必须记录“今天发生了哪些操作、哪些内容被修改过”,这就类似于 Oracle 中的 Redo(重做日志)。
除此之外,还需要一批各司其职的工作人员:
DBWR:负责把修改后的数据块写入数据文件;LGWR:负责把 Redo 写入在线重做日志;CKPT:负责协调检查点;SMON:参与实例恢复等系统维护;PMON:处理异常进程相关资源;ARCn:负责归档历史 Redo。
因此,从整体上看,可以先把 Oracle 理解为:
Oracle
=
内存
+
后台进程
+
磁盘文件
进一步看:
Oracle Database Server
│
├── Instance
│   ├── SGA
│   └── Background Processes
│
└── Database
    ├── Control File
    ├── Data File
    └── Online Redo Log
其中:
Instance = SGA + 后台进程
Instance 是 Oracle 的“运行环境”,而 Database 更偏向磁盘上真正持久保存的数据和文件。
二、Oracle 是怎样启动起来的
假设服务器刚刚开机,磁盘中的:
system01.dbf
users01.dbf
control01.ctl
redo01.log
redo02.log
...
这些文件仍然存在。
也就是说,数据库的物理文件还在,但 Oracle 的运行环境还没有建立,此时 Instance 还不存在。
管理员执行:
STARTUP; Oracle 会依次经历:
NOMOUNT
   ↓
MOUNT
   ↓
OPEN
NOMOUNT:先把 Instance 建起来
Oracle 首先读取 参数文件(Parameter File)。参数文件会告诉 Oracle:
- SGA 需要多大;
- PGA 如何管理;
- 数据库叫什么;
- Control File 在哪里;
- 允许多少进程等。
随后 Oracle 创建 SGA,并启动 DBWR、LGWR、SMON、PMON、CKPT 等后台进程。
于是:
SGA + Background Processes
              ↓
Instance 因此,NOMOUNT 阶段最核心的事情就是:
读取参数文件
    ↓
创建 SGA
    ↓
启动后台进程
    ↓
Instance 建立
此时 Oracle 已经“运行起来”,但还没有真正打开数据库。
MOUNT:找到数据库
Instance 建立后,Oracle 需要知道:
我的数据库到底由哪些文件组成?
这时就需要 Control File(控制文件)。
Oracle 打开 Control File 后,可以获得诸如:
- Data File 有哪些;
- Data File 在哪里;
- Online Redo Log 有哪些;
- 当前 Checkpoint 信息;
- 数据库当前状态等。
因此:
NOMOUNT
   ↓
打开 Control File
   ↓
MOUNT
可以把 MOUNT 理解成:
Oracle Instance 已经找到并识别了这个数据库。
OPEN:真正开放数据库
最后,Oracle 根据 Control File 中的信息打开:
Data File
+
Online Redo Log
检查正常后:
Database OPEN 此时普通用户才可以正常执行 SELECT、INSERT、UPDATE、DELETE 等操作。
所以整个启动过程可以压缩成:
Parameter File
      ↓
创建 Instance
      ↓
Control File
      ↓
找到数据库
      ↓
Data File + Online Redo Log
      ↓
Database OPEN
三、用户连接后,SQL 是谁执行的
假设用户打开 SQL Developer,并填写:
用户名
密码
IP
1521
Service Name
点击连接后,可以把过程简化理解为:
SQL Developer
      ↓
Oracle Listener
      ↓
Oracle Service
      ↓
Server Process
      ↓
Oracle Instance
Listener 可以理解为 Oracle 的“前台接待”。它接收客户端连接请求,并把用户连接到合适的 Oracle 服务。常见监听端口是 1521。
但 Listener 本身通常不负责执行 SQL。
真正执行数据库操作的是:
Server Process(服务进程)
例如用户输入:
SELECT *
FROM emp;
并不是 SQL Developer 自己去读取数据库文件,而是 Server Process 帮用户完成解析、访问数据并返回结果。
每个 Server Process 工作时还可能需要一块自己的私有内存,这就是:
PGA(Program Global Area)
可以简单记:
SGA → 多个进程共享
PGA → 进程私有
四、一条 SELECT 到底经历了什么
假设现在执行:
SELECT ename, sal
FROM emp
WHERE empno = 7369;
SQL 进入 Server Process 后,Oracle 通常不会立刻跑到磁盘上找数据,而是先处理 SQL 本身。
第一站是 SGA 中的:
Shared Pool(共享池)
共享池中有两个非常重要的区域:
Library Cache
Data Dictionary Cache
Library Cache(库缓存) 主要保存 SQL、PL/SQL、解析结果和执行计划等信息。Oracle 会检查这条 SQL 是否已经存在可以复用的解析结果;如果没有,就需要重新检查语法、确认对象,并决定走索引还是全表扫描等,最终形成执行计划。
可以把 Library Cache 理解成:
解决“这条 SQL 应该怎么执行”的问题。
而执行 SQL 时,Oracle 还必须知道:
emp 是什么表?
ename、sal、empno 是什么列?
当前用户有没有访问权限?
这些属于元数据,Oracle 会通过 Data Dictionary Cache(数据字典缓存) 获取相关信息。
完成解析后,Oracle 才真正开始找数据。
首先检查:
Database Buffer Cache
如果需要的数据块已经在 Buffer Cache 中,就直接从内存读取。
如果没有,则需要:
Data File
   ↓
读取 Data Block
   ↓
Buffer Cache
   ↓
Server Process
   ↓
返回给用户
需要注意,Oracle 的存储和访问是以 Data Block(数据块) 为重要单位展开的,而不是简单理解成“每次只从磁盘读一行”。
因此,一条查询可以概括为:
用户提交 SELECT
        ↓
Server Process
        ↓
Shared Pool
        ↓
解析 SQL / 获取执行计划
        ↓
Buffer Cache
     ┌──┴──┐
     │     │
   找到   未找到
     │     │
     │   Data File
     │     ↓
     └→ Buffer Cache
            ↓
      Server Process
            ↓
         返回结果
五、UPDATE、Redo 和 COMMIT 是整个体系的关键
相比查询,数据修改更能体现 Oracle 的体系结构。
假设执行:
UPDATE emp
SET sal = 10000
WHERE empno = 7369;
Oracle 通常不会直接修改磁盘上的 Data File。
它会先确保目标数据块已经进入:
Database Buffer Cache
然后在内存中修改这个数据块。
此时就可能出现:
Buffer Cache 中:新数据
Data File 中:旧数据
这个已经被修改、但还没有写回磁盘的数据块称为:
Dirty Buffer(脏块)
问题随之而来:
如果服务器现在突然断电,内存中的修改不是就丢了吗?
这就是 Oracle 为什么需要 Redo。
当 Oracle 修改 Buffer Cache 中的数据块时,同时会生成 Redo Record,先放入:
Redo Log Buffer
于是,一次 UPDATE 实际上形成了两条路线:
                    UPDATE
                       │
          ┌────────────┴────────────┐
          │                         │
     修改数据块                  产生 Redo
          │                         │
    Buffer Cache             Redo Log Buffer
          │                         │
         DBWn                      LGWR
          │                         │
          ↓                         ↓
      Data File             Online Redo Log
左边是“真正的数据”,右边是“对数据做了什么修改的记录”。
其中:
DBWn
→ 把 Dirty Buffer 写入 Data File
而:
LGWR
→ 把 Redo Log Buffer 中的 Redo 写入 Online Redo Log
这两个进程一定要区分清楚:
DBWn 写数据,LGWR 写日志。
接下来用户执行:
COMMIT; 一个非常重要的理解是:
COMMIT 并不意味着 DBWR 必须立刻把本次事务涉及的所有数据块写入 Data File。
Oracle 更重要的是保证:
本次事务相关的 Redo 已经可靠地写入 Online Redo Log。
因此可以把提交理解成:
COMMIT
   ↓
LGWR
   ↓
Redo Log Buffer 中相关 Redo 写盘
   ↓
Online Redo Log
   ↓
事务提交完成
为什么要这样设计?
因为 Redo 更适合连续写入,而真正的数据块可能分散在不同数据文件、不同磁盘位置。如果每次 COMMIT 都要求所有数据块立即写盘,数据库性能会明显下降。
所以 Oracle 的基本思路可以通俗地理解为:
先把“我做过什么修改”可靠记录下来,再由 DBWnR在合适的时机把真正的数据块写回磁盘。
这样,即使提交之后服务器突然断电,只要相关 Redo 已经可靠保存,Oracle 仍然可以在恢复过程中利用 Redo 重新恢复修改。
六、CKPT、ARCn、SMON 和 PMON 在做什么
数据库长时间运行后,Buffer Cache 中会不断出现 Dirty Buffer,Redo 也会不断产生。Oracle 还需要一系列后台机制维护整个系统。
CKPT:协调检查点
CKPT 对应 Checkpoint。
它并不是直接把数据块写进 Data File,真正负责写数据的仍然是 DBWR。
可以把 CKPT 理解成一个“协调员”:
CKPT
   ↓
协调检查点推进
   ↓
DBWn 完成必要的数据块写出
   ↓
更新 Control File 等检查点信息
Checkpoint 的意义之一,是不断推进“数据库磁盘状态已经跟进到哪里”,从而减少发生故障时需要恢复的工作量。
ARCn:保存历史 Redo
Online Redo Log 的空间不是无限的,它会循环使用。
ARCn 的主要作用就是在归档模式下,把需要保留的历史 Redo 保存下来:
Online Redo Log
      ↓
     ARCn
      ↓
Archived Redo Log
这些归档日志对于后续备份与恢复非常重要。
SMON:实例恢复
如果 Oracle 实例因为断电等原因异常终止,重新启动后可能需要利用 Redo 恢复数据库状态。
SMON 会参与:
Instance Recovery(实例恢复)
相关工作。
PMON:处理异常进程资源
如果不是整个数据库崩溃,而是某个用户进程或 Server Process 异常终止,那么 PMON 会参与处理相应的异常进程资源。
七、最后把整条主线串起来
现在再回头看,Oracle 19c 的体系结构其实可以浓缩成下面这一张流程图:
                      Oracle 启动
                          │
                          ↓
                   Parameter File
                          │
                          ↓
                SGA + 后台进程
                          │
                          ↓
                       Instance
                          │
                          ↓
                    Control File
                          │
                          ↓
              Data File + Online Redo Log
                          │
                          ↓
                         OPEN
                          │
                          ↓
                    用户提交 SQL
                          │
                          ↓
                   Server Process
                          │
                ┌─────────┴─────────┐
                │                   │
               PGA                 SGA
                                     │
                  ┌──────────────────┼──────────────────┐
                  │                  │                  │
             Shared Pool       Buffer Cache       Redo Log Buffer
                  │                  │                  │
              SQL 解析            数据块              Redo
                                     │                  │
                                    DBWn               LGWR
                                     │                  │
                                     ↓                  ↓
                                 Data File       Online Redo Log
                                                        │
                                                       ARCn
                                                        │
                                                        ↓
                                                 Archived Redo Log
如果只记住一句话,可以这样概括:
Oracle 先在内存中完成 SQL 解析和数据处理;查询尽量从 Buffer Cache 获取数据;修改数据时既会产生 Dirty Buffer,也会产生 Redo;LGWR 优先保证日志可靠落盘,DBWR 再把数据块写回 Data File;CKPT 协调检查点,ARCn 保存历史日志,而数据库发生故障后可以利用 Redo 进行恢复。
因此,Oracle 这套体系结构实际上一直围绕三个目标展开:
如何执行得更快?
→ SGA + Buffer Cache

如何保证提交的数据不轻易丢失?
→ Redo + LGWR

如何在发生故障后恢复?
→ Redo + Checkpoint + Archive
理解了这条主线,再继续学习 SGA、PGA、Redo、Undo、表空间、归档、备份恢复等内容,就会容易很多。
0 次表情反馈 · 0 条评论